오늘의 질문
아이 숙제나 내 공부를 도와줄 AI 6종을 비교했다. 종합 평균 9.3점을 받은 GPT-6 Astra가 가장 높은 평가를 받았다. 이번 질문은 “어떤 AI가 가장 잘 가르쳐 주느냐"다. 정답을 맞히는 데서 그치지 않고, 아이가 알아들을 말로 설명하는지, 스스로 풀 여지를 남기는지도 함께 봤다.
영어 문법 문제는 여섯 모델이 모두 맞혔다. 대신 설명과 힌트의 품질에서 차이가 났다. 공부 도우미를 고를 때는 정답률뿐 아니라 어떤 방식으로 알려 주는지를 봐야 한다는 뜻이다.
이렇게 시험했다
2026년 9월 24일, 여섯 모델에 똑같은 프롬프트(AI에게 주는 지시문)를 넣었다. 설정은 모두 기본값으로 뒀고, 모델마다 각 문제를 한 번씩만 실행했다.
비교 대상은 회사별로 상위 모델과 가벼운 모델을 섞었다. 앤트로픽은 Claude Opus 5.5(상위 모델)와 Claude Haiku 4.5(가벼운 모델), 오픈AI는 GPT-6 Astra(상위 모델)와 GPT-6 Luna(가벼운 모델)를 넣었다. 구글의 Gemini 3.5 Flash는 가벼운 모델이다. xAI의 Grok 4.5는 이전 세대 상위 모델이다. xAI는 9월 21일 Grok 4.7을 발표했다.
Gemini 3.5 Flash와 Grok 4.5는 GitHub Copilot으로 실행했다. 실행 경로가 달라 응답 속도를 그대로 맞비교하기는 어렵다. 각 모델에 짧은 확인 답변을 먼저 시켜 준비 시간을 재고, 문제 응답 시간에서 그 값을 뺐다.
채점은 Claude Opus 5와 GPT-6 Sol이 맡았다. 두 심사 모델은 어느 회사의 답변인지 모르는 상태에서 각각 10점 만점으로 점수를 매겼다. 정답 판정은 둘 다 동의해야 인정하고, 의견이 갈리면 판정 갈림으로 처리했다. 이번에 정답을 집계한 문제는 문법 문제 하나뿐이고, 나머지 두 문제는 설명의 품질만 점수로 봤다.
문제 1: 아이에게 물가 설명하기
어려운 개념을 아이 눈높이에서 짧게 풀어내는지 보는 문제다.
초등학교 5학년에게 '인플레이션'을 설명해 줘. 용돈과 과자 가격을 예로 들어서, 5문장 이내로.
Claude Opus 5.5가 9.5점으로 앞섰고, GPT-6 Astra가 9.0점으로 뒤를 이었다. 두 모델 모두 같은 용돈으로 살 수 있는 과자 수가 줄어드는 장면을 숫자로 보여 줬다. Claude Opus 5.5는 용돈 10,000원으로 사던 과자가 10개에서 8개로 줄어드는 예를 들었다. GPT-6 Astra는 5,000원으로 5봉지를 사다가 가격이 오르면 4봉지만 사게 되는 예를 썼다.
핵심은 가격 상승을 아이가 직접 셀 수 있는 과자 개수로 바꿨다는 점이다. 두 모델의 응답 시간은 나란히 2.4초였다. 좋은 설명을 받으려고 더 오래 기다릴 필요는 없었던 셈이다.
Gemini 3.5 Flash와 Grok 4.5는 각각 8.5점, GPT-6 Luna는 8.0점을 받았다. Claude Haiku 4.5는 7.0점으로 가장 낮았다. 제목과 강조 표시가 불필요하고, 용돈 액수와 과자 가격의 연결이 덜 구체적이라는 지적을 받았다. GPT-6 Luna도 오른 과자 가격을 숫자로 밝히지 않은 점이 아쉬움으로 꼽혔다.
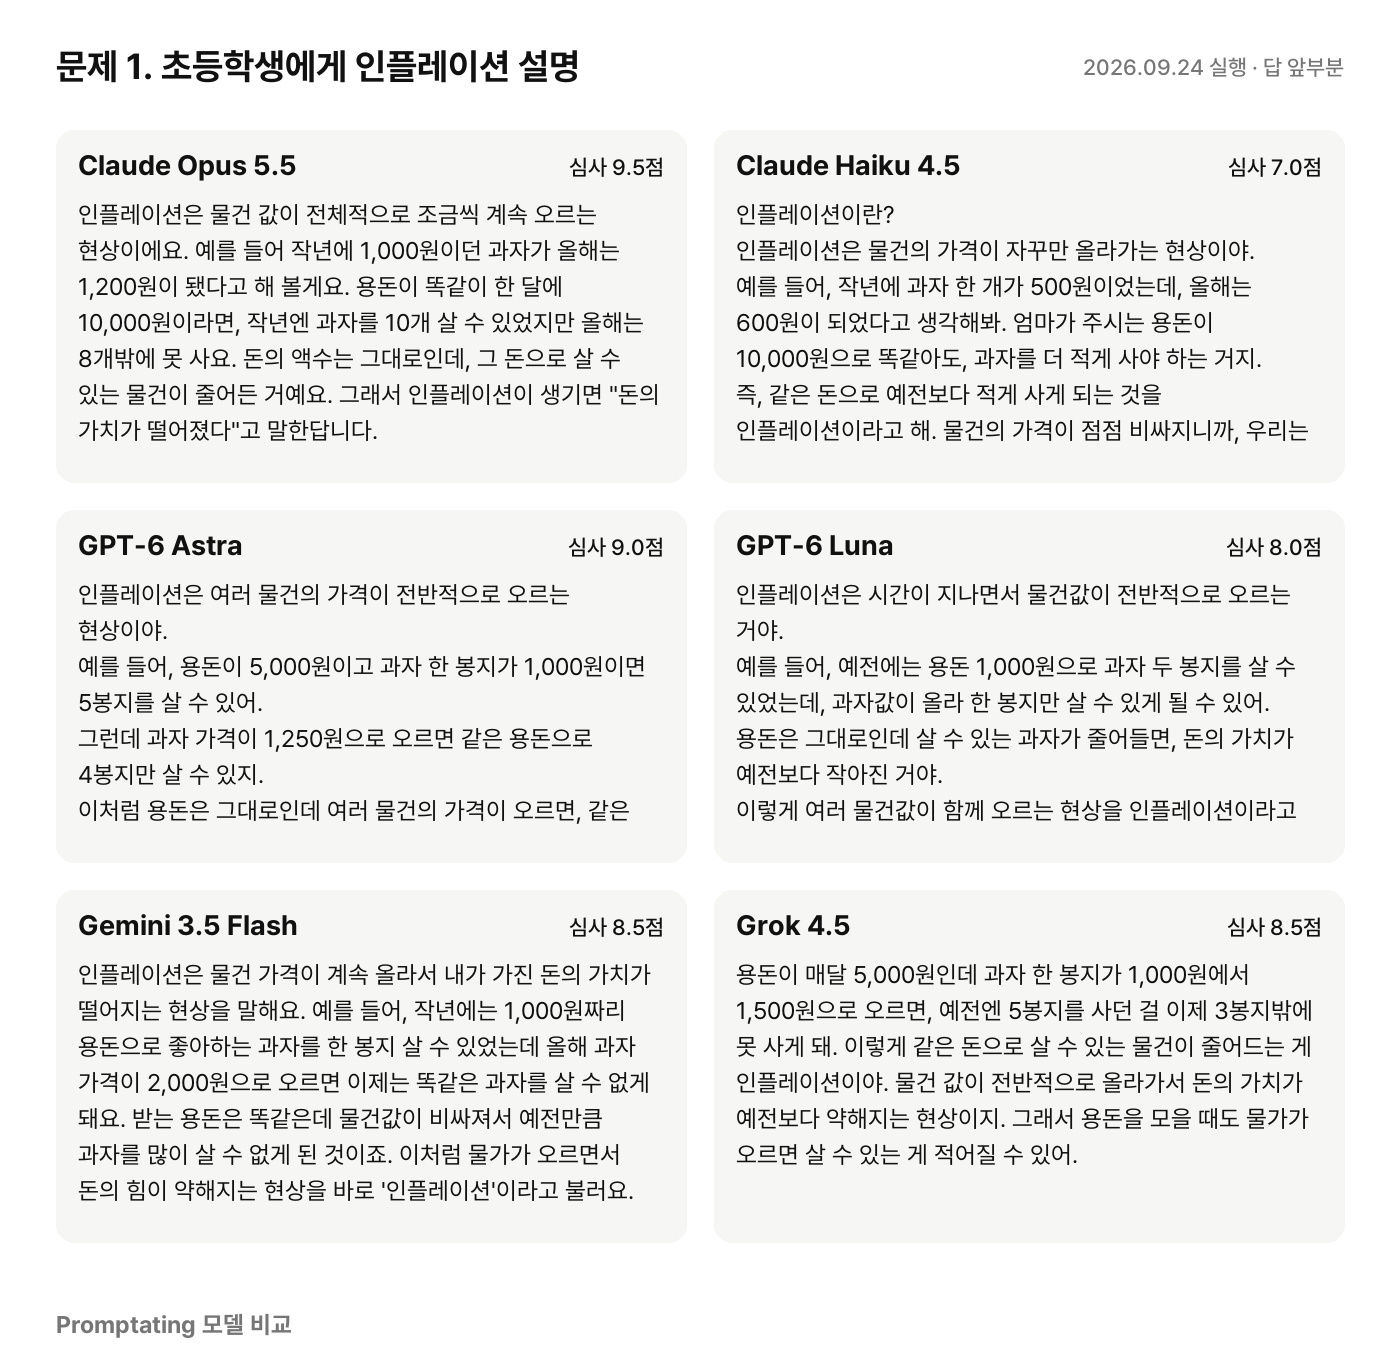
문제 1에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
문제 2: 답은 숨기고 힌트만 주기
학생 대신 풀어 주지 않고, 다음 계산을 스스로 찾게 돕는지 살폈다.
중학생이 '어떤 수에 3을 곱하고 7을 더했더니 25가 되었다. 어떤 수는?'이라는 문제를 풀고 있다. 정답은 말하지 말고, 스스로 풀 수 있게 힌트를 단계별로 2개만 줘.
GPT-6 Astra와 Gemini 3.5 Flash가 나란히 9.0점을 받았다. GPT-6 Astra는 식을 세우게 한 뒤 마지막 계산을 질문으로 남겼다. Gemini 3.5 Flash는 마지막에 더한 수를 되돌리게 하고, 그 결과가 어떤 곱셈에서 나왔는지 생각하게 했다. 응답 시간은 각각 3.9초와 2.3초다. 이 문제에서는 가벼운 모델도 상위 모델과 같은 점수를 받았다.
GPT-6 Luna는 1.2초로 가장 빨랐지만 5.5점에 그쳤다. “3을 먼저 없애려면"이라는 안내가 문제가 됐다. 두 심사 모델 모두 더한 7부터 되돌리는 대신 곱한 3을 먼저 처리하게 해 풀이 순서를 헷갈리게 할 수 있다고 봤다. 정답 숫자를 가렸다고 해서 곧 좋은 힌트가 되는 것은 아니었다.
Claude Opus 5.5는 8.5점이었다. 계산을 거꾸로 되돌리는 설명은 좋았지만, 검산 안내를 힌트 두 개 밖에 따로 덧붙였다는 지적을 받았다. Grok 4.5는 7.5점, Claude Haiku 4.5는 5.5점이었다. 풀이 절차를 어디까지 알려 줘야 하는지를 두고는 두 심사 모델의 평가도 갈렸다.
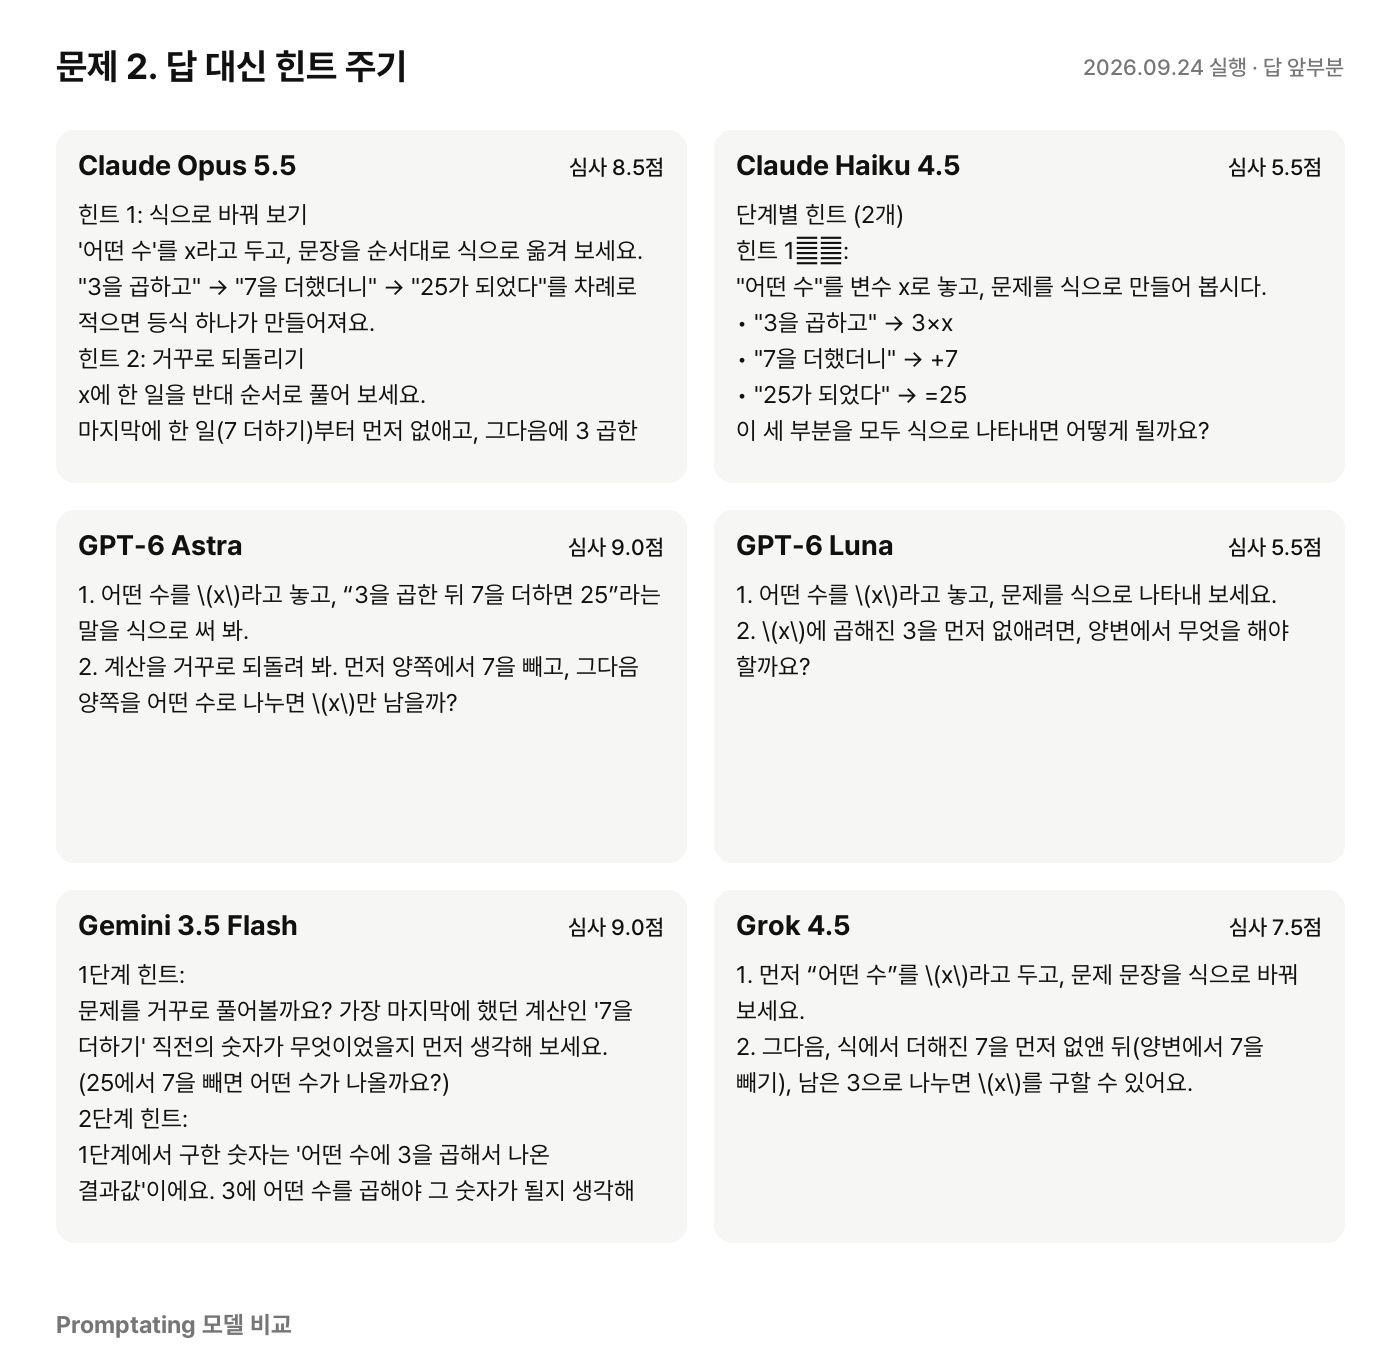
문제 2에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
문제 3: 영어 문법 고치기
틀린 곳을 고치고 그 이유를 한국어 한 문장으로 설명하는지 확인했다.
다음 영어 문장에서 틀린 부분을 고치고, 왜 틀렸는지 한국어 한 문장으로 설명해 줘.

"She don't like coffee, but she have tea every morning."
여섯 모델 모두 핵심 수정인 doesn’t와 has를 맞혔다. GPT-6 Astra가 10.0점, GPT-6 Luna가 9.5점으로 앞섰다. 두 모델은 고친 문장과 짧은 이유를 함께 내놨다. 응답 시간도 각각 1.0초와 1.4초로 빨랐다. 이 정도 문법 교정이라면 가벼운 GPT-6 Luna로도 충분했다.
Gemini 3.5 Flash는 9.0점, Claude Opus 5.5는 8.5점, Grok 4.5는 8.0점, Claude Haiku 4.5는 7.5점을 받았다. 정답은 같아도 설명의 정확성과 답변의 간결함에서 점수가 갈렸다. Grok 4.5는 이 문제에 16.0초를 썼지만, 오래 기다린 만큼 점수가 높지는 않았다.
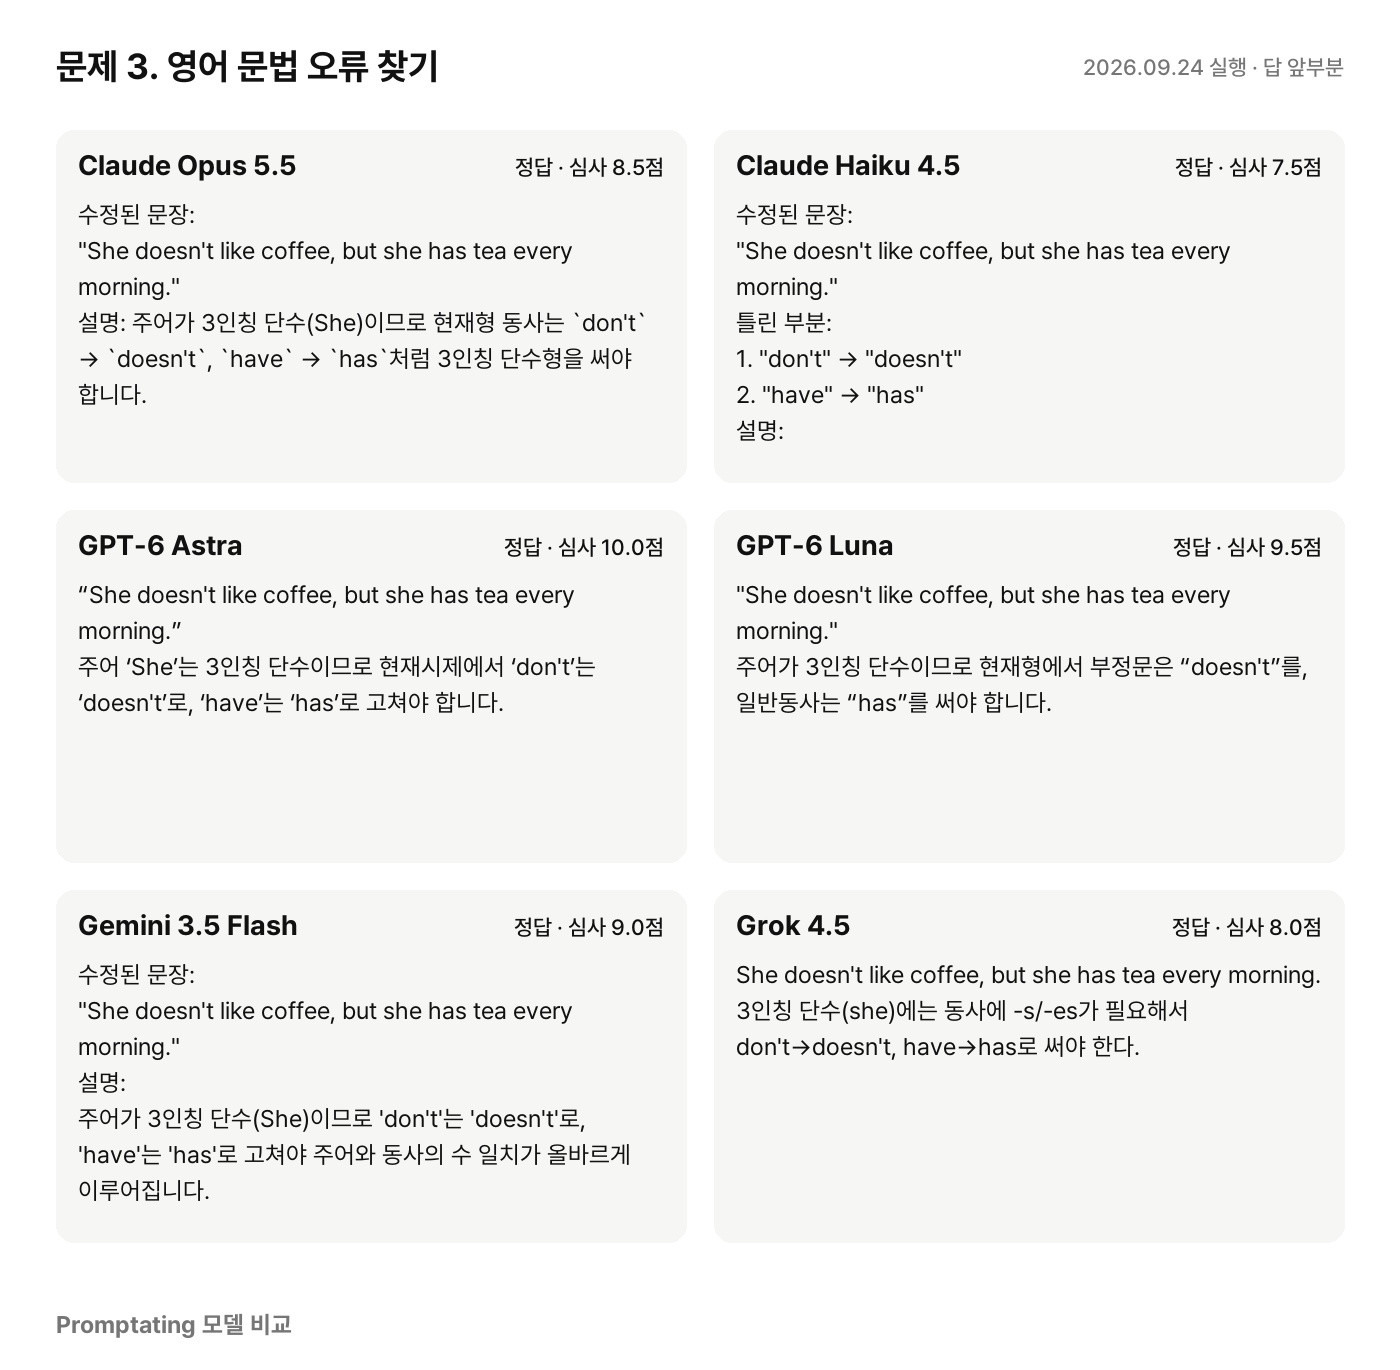
문제 3에 대한 모델별 실제 답 (2026년 9월 24일 실행, 앞부분만)
이번 라운드 성적표
| 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 | 출력 속도(초당 글자) |
|---|---|---|---|---|
| GPT-6 Astra | 9.3점 | 1/1 | 2.4초 | 78자 |
| Claude Opus 5.5 | 8.8점 | 1/1 | 2.1초 | 127자 |
| Gemini 3.5 Flash | 8.8점 | 1/1 | 3.3초 | 62자 |
| Grok 4.5 | 8.0점 | 1/1 | 7.6초 | 35자 |
| GPT-6 Luna | 7.7점 | 1/1 | 2.1초 | 68자 |
| Claude Haiku 4.5 | 6.7점 | 1/1 | 4.5초 | 54자 |
응답 시간은 준비 시간을 뺀 값이다. 실행 경로가 달라 참고용으로만 보면 된다. 출력 속도는 문제별 초당 글자 수의 평균이다.
그래서 뭘 쓰면 될까
여러 공부 과제를 두루 맡길 생각이라면 이번 종합 1위인 GPT-6 Astra가 첫 후보다. 아이 눈높이 설명이 주목적이라면 해당 문제에서 9.5점을 받은 Claude Opus 5.5도 살펴볼 만하다.
스스로 풀게 돕는 힌트가 필요하다면 가벼운 Gemini 3.5 Flash로도 충분하다. 상위 모델인 GPT-6 Astra와 똑같은 9.0점을 받았다.
빨리 답을 받고 싶다면 과제별로 따져 보는 게 좋다. GPT-6 Luna는 문법 교정에서 1.4초 만에 9.5점을 받았다. 반면 수학 힌트에서는 가장 빨랐어도 안내가 아쉬웠다.
상위 모델이라고 늘 오래 기다리는 것도 아니었다. Claude Opus 5.5는 평균 2.1초로 가벼운 GPT-6 Luna와 같았고, GPT-6 Astra도 2.4초였다. 반대로 Grok 4.5는 평균 7.6초를 쓰고도 8.0점에 그쳤다. 다만 이 비교는 시간과 답변 품질만 본 것이다. 비용까지 따진 선택은 따로 살펴야 한다.
지금까지 누적 순위
| 순위 | 모델 | 평균 심사 점수 | 정답 | 평균 응답 시간 |
|---|---|---|---|---|
| 1 | GPT-6 Astra | 9.2점 | 8/8 | 2.4초 |
| 2 | Claude Opus 5.5 | 8.9점 | 8/8 | 1.8초 |
| 3 | Gemini 3.5 Flash | 8.8점 | 8/8 | 2.6초 |
| 4 | Grok 4.5 | 8.7점 | 8/8 | 3.5초 |
| 5 | GPT-6 Luna | 7.6점 | 6/8 | 1.1초 |
| 6 | Claude Haiku 4.5 | 6.8점 | 8/8 | 5.0초 |
4개 라운드를 합친 순위에서도 GPT-6 Astra가 평균 점수로 앞섰다. Claude Haiku 4.5처럼 정답은 다 맞히고도 설명 점수는 낮은 경우도 있다.
이번 비교의 한계
문제는 세 개뿐이고, 모델마다 각 문제를 한 번씩만 실행했다. 점수도 AI가 매긴 참고 값이다. 실제 학생의 이해도가 얼마나 늘었는지를 잰 결과는 아니다. 그래도 가벼운 모델이 특정 공부 과제에서 상위 모델만큼 좋은 평가를 받을 수 있다는 점은 확인됐다. 앞으로는 난도가 다른 문제를 여러 번 반복해도 설명과 힌트의 품질이 유지되는지 봐야 한다.
모델 비교 다른 기사
회사 글쓰기 AI 비교, 가벼운 GPT-6 Luna가 1위
한국어 업무 글쓰기 세 문제에서 가벼운 GPT-6 Luna가 평균 9.7점으로 가장 높았다. 정답이 있는 두 문제는 여섯 모델 모두 통과했다.
할인 계산도 일정 잡기도, 가벼운 AI가 모두 맞혔다
Claude Haiku 4.5와 Gemini 3.5 Flash는 세 문제를 모두 맞혔다. 가장 빨랐던 GPT-6 Luna는 두 문제를 틀려, 속도만 보고 고르기는 어려웠다.
상식 문제는 AI 6개 다 맞혔지만, 직장 예절은 갈렸다
AI 모델 6개에 같은 질문 3개를 물었다. 기본 상식과 "모른다"는 답은 가벼운 모델도 잘했지만, 직장 호칭을 설명하는 능력은 모델마다 달랐다.